Ecosistema .NET: SQL Database Migrations con Evolve
En el pasado, hacer cambios de base de datos SQL/Relacional, ya sea crear nuevas tablas, modificar campos en una tabla existente o crear otro tipo de objeto como claves foráneas, reglas de restricción o procedimientos almacenados, era un proceso manual. En muchos equipos se necesitaba la coordinación de más de un rol para poder hacer estos cambios en cada uno de los ambientes, y en producción era todo un ritual de aprobaciones que demandaba más o menos los siguientes pasos:
- Los desarrolladores elaboraban scripts SQL a mano con todos sus cambios, luego solicitaban la ejecución de estos cambios al administrador de base de datos (DBA).
- El DBA hacía una revisión para ver si estos scripts cumplían con los lineamientos y forma, para pasar a un proceso de ejecución solo si pasaba toda su revisión.
- En el proceso de ejecución, muchos equipos de base de datos o DBAs realizaban un backup previo y preventivo.
- Después de la ejecución, muchos equipos tenían bitácoras de control de cambios en Excel o en algún otro medio, además de carpetas donde organizaban los archivos de scripts que se iban ejecutando.
Como se puede entender, era un proceso manual que demandaba varias coordinaciones y que muchas veces traía problemas consecuentes como: ambientes no sincronizados, formatos de control no actualizados y tiempos largos para ejecutar una acción que, desde el punto de vista de negocio, es trivial.
Para atacar estos problemas es que nace el concepto de “Database Migrations”. Para dar los créditos a quien lo merece, es un concepto que no introdujo el ecosistema Java ni el ecosistema .NET, sino que fue Ruby on Rails entre el 2004-2005. La idea era simple, pero poderosa: “la base de datos debe evolucionar junto con el código”. Posteriormente, muchos ecosistemas como Python, Java, .NET, entre otros, también lo adoptaron.
Para el caso de .NET, desde 2012-2013 se introduce Entity Framework Migrations para lograr que, mediante código y sintaxis de Entity Framework, se generen estos cambios de base de datos y, a la vez, se guarde un historial de los cambios aplicados.
Que el código de la aplicación se refleje como cambios de base de datos es, de hecho, genial y muy útil para muchos casos y equipos con un enfoque ágil. Por ejemplo, esta agilidad es muy valorada en microservicios, pero manejarlo todo por código hace que otro tipo de roles, como los especialistas de datos o incluso los DBAs, pierdan visibilidad por no estar muy familiarizados con el código. Es aquí donde nacen otro tipo de alternativas y herramientas que buscan un enfoque intermedio. Este enfoque consiste en que los cambios se sigan escribiendo como scripts SQL, pero que puedan automatizarse en el despliegue y/o lanzamiento de la aplicación o microservicio.
Con ese enfoque intermedio nacen alternativas como Evolve. Evolve, como herramienta de migración de base de datos, está basado en los conceptos de Flyway para Java, pero en este caso para .NET. Por lo tanto, puedes usar Evolve para automatizar los cambios de tu base de datos en tus flujos de integración continua.
¿Cómo se trabaja con Evolve?
Evolve tiene dos conceptos de migración: migración versionada y migración repetible. Evolve buscará todos los archivos de script en la ubicación especificada de forma recursiva en todos los subdirectorios, ordenando los scripts que comiencen por “V” de forma ascendente, de igual manera los que comienzan con “R”, pero ordenados por el nombre.
- Migración versionada: Empiezan por “V” y deben tener un nombre en formato de versión que sea único, por ejemplo “V1_3_1_1__Create_table.sql”. Evolve ejecuta el archivo y lo guarda en su historial de cambios para no volverlo a ejecutar en un siguiente lanzamiento. Ideal para aplicar cambios de esquema (nuevas tablas, nuevos campos, objetos de restricción, índices, entre otros).
- Migración repetible: Empiezan por “R”, por ejemplo “R__Create_views.sql”. Evolve ejecuta estos archivos solo si ha cambiado su contenido. Es ideal para mantener listas de objetos como procedimientos almacenados y vistas, o para insertar data de inicialización que puede crecer con el tiempo.
Como se puede entender, Evolve sirve para la evolución y cambios de esquema de base de datos, así como para controlar la evolución de objetos como procedimientos y vistas, entre otros. Por lo tanto, no se recomienda el uso de herramientas como Evolve para la inserción de data masiva o procesos complejos y largos.
¿Cómo aplicar Evolve en microservicios?
Uno de los principios de microservicios es que cada microservicio debe ser “dueño” de una base de datos. Bajo este principio, se puede implementar Evolve de tal manera que se ejecute al inicializar el microservicio y aplique todas las migraciones que se escribieron. Incluso, bajo un enfoque de tener una sola base de datos física, cada microservicio trabajaría con su propio esquema de base de datos y se puede configurar Evolve para que trabaje a nivel de esquema.
Dejo el enlace a un repositorio de ejemplo para este tipo de implementación de Evolve con microservicios.
Repositorio de ejemplo: Evolve con microservicios :)
¿Qué pasa si tengo un monolito o servicios con una base de datos compartida y enfoque de trabajo más “tradicional”?
Si actualmente estás trabajando con un monolito, ya sea un monolito acoplado o un monolito modular, o incluso trabajas con servicios que se conectan a una base de datos compartida y trabajas de una forma “tradicional”, ya que los especialistas de base de datos o DBAs son los que supervisan y aprueban los cambios de base de datos, puedes implementar Evolve para hacer más eficientes los despliegues de cambios de base de datos. La implementación podría ser parecida a lo siguiente:
- Tener un repositorio central o un monorepo con una carpeta donde se concentren los scripts de migración de base de datos; incluso estos scripts podrían ser escritos por los mismos especialistas de base de datos.
- Implementar un pipeline, por ejemplo con GitHub Actions, que use Evolve como una tool de línea de comando o CLI para correr estos scripts, se conecte a la base de datos y ejecute el proceso de migración de Evolve.
- Para que este pipeline se lance, el PR específico debe aprobarse, pero para esta aprobación puedes exigir la revisión de un miembro de un grupo de especialistas de datos.
- Si deseas que la ejecución de las migraciones de base de datos se realice antes de desplegar los servicios o el monolito, puedes implementar workflows composables con jobs dependientes.
¿Qué consideraciones de seguridad debo tener para integrar Evolve a mis pipelines?
Si integras Evolve a tus pipelines de CI/CD, por ejemplo workflows de GitHub Actions, y dependiendo de la criticidad de tus datos o solución, puedes tomar diferentes posturas de seguridad, pero en líneas generales puedo sugerirte las siguientes:
- Cualquier dato sensible, ya sea una conexión de base de datos, usuarios o contraseñas de base de datos, debe estar protegido en un vault de secretos. Para iniciar, puede bastarte el vault que te brinda GitHub Actions, pero para escenarios más críticos y exigentes puedes usar Azure Key Vault.
- El usuario que uses para la ejecución de las migraciones debe estar configurado correctamente, en el sentido de que solo debe tener acceso para crear objetos dentro de su ámbito, sin poder acceder a componentes sensibles o ejecutar acciones para las que no debería tener acceso.
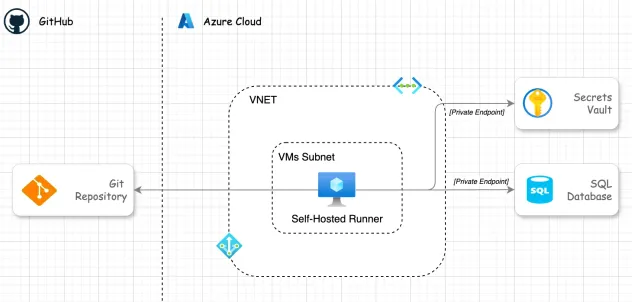
- Las bases de datos, por considerarse uno de los componentes principales de cualquier sistema, suelen estar aisladas de internet y trabajan en un contexto de red interna, por ejemplo dentro de Azure sería una VNET. Para que tu pipeline que usa Evolve pueda conectarse a la base de datos, debe correr en un “self-hosted runner” dentro de una máquina virtual en la VNET y con acceso para llegar a la base de datos.
El siguiente diagrama puede explicar esta implementación para base de datos compartida con enfoque seguro.
Conclusión
Evolve es una gran alternativa para implementar Database Migrations en un ecosistema .NET o incluso no .NET, por tener capacidades vía CLI. Dependiendo de tu caso de uso, debes tener en cuenta situaciones como forma de trabajo y cultura. Por otro lado, ver si lo estás aplicando para un monolito o en microservicios, sin dejar de lado las cuestiones de seguridad.
Sígueme en Linkedin para estar al tanto de mis publicaciones y novedades