Azure Service Bus: Entendiendo el Ciclo de Vida de un Mensaje
En un artículo pasado comenté un poco sobre flujos asíncronos y/o reactivos, y sobre uno de los componentes recurrentes y más extendidos para implementar flujos asíncronos: las colas de mensajería. En ese caso hablé específicamente de Azure Service Bus, un servicio PaaS de Azure Cloud que permite implementar mecanismos basados en colas e incluso tópicos. Dejo el enlace al artículo en mención por si te animas a leerlo y obtener un poco más de contexto.
Arquitectura y Flujos Asíncronos en Azure: Alternativas y Criterios de Decisión
Ahora quiero ahondar un poco en el ciclo de vida y los estados por los cuales pasa un mensaje. Este tema me parece fundamental para implementar comportamientos en tus flujos asíncronos, por ejemplo, para diseñar mecanismos de reintento que se ajusten a tu caso de uso.
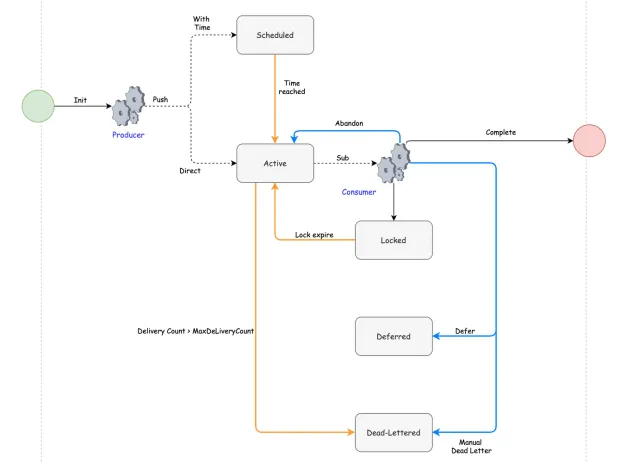
Sin más preámbulo, el siguiente diagrama explica de gran manera cómo nace un mensaje, los estados por los que pasa y los desencadenantes que hacen que cambie de un estado a otro, así como los actores involucrados:
Ciclo de Vida de un Mensaje en Azure Service Bus
El diagrama anterior representa una especie de máquina de estados para un mensaje en Azure Service Bus. Esta figura aplica tanto para colas como para tópicos. Las líneas punteadas representan las acciones de escritura (push) y lectura (sub) por parte de los productores y consumidores, respectivamente. Las líneas en naranja representan los cambios de estado que realiza el motor de Service Bus automáticamente, mientras que las líneas azules representan los cambios de estado que son gatillados por el consumidor durante el procesamiento del mensaje.
Veamos ahora cómo se pueden comprender estos estados desde el “inicio”, cuando el mensaje es “creado” por un producer y tomado por un consumer para su procesamiento, hasta que se “completa” su objetivo y finaliza el ciclo.
Active
Este se puede considerar el primer estado para la gran mayoría de mensajes entrantes si el productor no especifica una programación explícitamente. El estado activo indica que el mensaje está listo para su consumo y cualquier subscriptor libre podría tomarlo.
Scheduled
Este estado solo ocurre cuando el consumidor indica explícitamente que quiere programar el mensaje. Aunque el mensaje fue entregado, se debe esperar un tiempo para que pueda estar disponible para consumo. Esto se logra con la propiedad scheduledEnqueueTimeUtc, que es un valor de fecha y hora (DateTime) que indica en qué momento el mensaje se hace visible para los suscriptores. Es en ese momento cuando el motor pasa el mensaje a estado activo.
Locked
Este es el estado que ocurre cuando un suscriptor toma el mensaje en modo peek-locked, es decir, le indica al motor que lo ha tomado y que lo tendrá bloqueado hasta que termine su procesamiento o indique otro tipo de acción. Este modo peek-locked es el modo pull por defecto y recomendado para la gran mayoría de los casos de uso, aunque existe otro modo donde el consumidor toma el mensaje y le indica al motor que lo considere eliminado del broker.
En este punto, el consumidor puede decidir abandonar el mensaje. Esto hará que el motor lo considere nuevamente activo, pero aumente el deliveryCount en 1. Otro escenario posible es que el consumidor retenga el mensaje por mucho tiempo y no indique ninguna acción; para estos casos se puede configurar un tiempo máximo de bloqueo. Si se llega a ese tiempo, el bloqueo del consumidor expira, el deliveryCount aumenta en 1 y el mensaje vuelve a considerarse activo.
Deferred
Deferred es un estado al que solo se puede llegar si el consumidor lo indica explícitamente. Este estado suele ser útil para escenarios de orquestación, pero el consumidor debe guardar un número de secuencia que le servirá luego para poder buscar ese mensaje. Por ejemplo, puede usarse para manejar dependencias lógicas entre mensajes.
Dead-Lettered
A este estado se puede llegar de dos formas:
- Por indicación explícita del consumidor (envío manual), lo que hace que el mensaje vaya a la famosa “cola de cementerio”.
- Cuando el deliveryCount supera el máximo permitido en maxDeliveryCount. En este caso, es el broker quien automáticamente envía el mensaje a la cola de cementerio.
Llegados a este punto, quizás te estés preguntando: ¿Cómo utilizo esto para los reintentos? Analicemos un poco.
- Si todo va según lo planeado, el consumidor debe completar el mensaje. Esto hace que el ciclo termine y el broker elimine el mensaje.
- En caso de fallo, el consumidor puede abandonar el mensaje para que este vuelva a activarse y se entregue a otro consumidor (o al mismo). De esta forma se obtiene una especie de reintento automático, pero se debe tener cuidado y configurar un maxDeliveryCount bajo para evitar loops infinitos.
- En otro escenario, el consumidor puede decidir enviar el mensaje a la cola de cementerio. Esta cola podría tener un consumidor responsable de reencolar el mensaje en la cola original. Para hacer más robusto el reintento, se le puede sumar un tiempo de espera por cada reintento, de manera que estos se vuelvan más efectivos en situaciones de indisponibilidad de alguna dependencia del consumidor, incrementando la probabilidad de éxito. Si después de varios de estos reintentos robustos sigue fallando, se debe romper el ciclo con alguna notificación o acción según tu caso de uso.
Este patron de reintento se puede explicar mejor con la siguiente imagen:
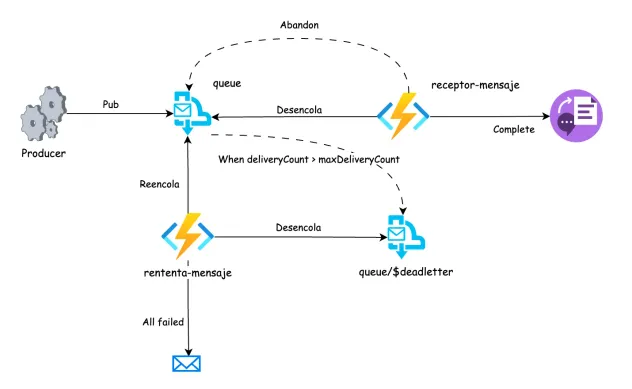
Además, acompaño este pequeño diagrama con un repositorio que intenta emular este comportamiento de forma forzada con fines prácticos y de ejemplo, para ello he utilizado el SDK de Azure Functions para construir funciones que escuchan de una cola de ejemplos en Azure Service Bus.
Repositorio de ejemplo - Azure Functions con Azure Service Bus :)
Conclusiones
- Azure Service Bus es un gran servicio para implementar mensajería empresarial. Cuenta con estados y propiedades que te permiten implementar comportamientos como los reintentos. Sin embargo, hay otras capacidades como reenvío, sesiones y transacciones que no han sido mencionadas, pero que también son muy interesantes.
- El patrón de reintento explicado suele ser muy usado en ambientes de producción, pero debes analizar tu propio caso de uso y determinar si es aplicable a tu realidad, de lo contrario, podrías terminar implementando una complejidad innecesaria.
- Se debe tener en cuenta que muchos estados son gatillados por el consumidor desde el código y a su vez existen muchas librerías y SDKs que ya permiten manejar los flujos y lo asbtraen al desarrollador, por ejemplo el SDK de Azure Functions ya viene preparado para manejar estos cambios de estado de “caja”.
Sígueme en Linkedin para estar al tanto de mis publicaciones y novedades